Beim Älterwerden denkt man zwangsläufig öfter an die Vergangenheit zurück. Als ich kürzlich eine neue Workstation eingerichtet habe, musste ich deshalb unweigerlich an meinen ersten PC denken. Ich hatte ihn 1993 gekauft: ein 386DX-40 mit 4 MB RAM und einer 170-MB-Festplatte – ein gewaltiger Sprung im Vergleich zum Commodore 64, den ich zuvor zur Verfügung hatte, es sei denn, ich schwang mich aufs Fahrrad für eine Fahrt ins Nachbardorf, wo der alte 286er meines Onkels stand. Trotz eines zwischenzeitlichen Upgrades auf einen 486DX-50 war dieser Computer sechs Jahre später dennoch völlig veraltet. Deshalb ersetzte ich ihn 1999 durch einen Pentium III 450 mit 128 MB RAM und einer 10-GB-Festplatte. Dieser Computer deckte meinen Rechenbedarf während meiner Zeit an der Universität. Beim Betriebssystem wechselte ich von MS-DOS 6.22 und Windows 3.11 zu Windows 98 SE und SuSE Linux.
Was für ein Unterschied zu heute – meine alte Workstation, inzwischen auch schon mehr als sechs Jahre alt, verrichtet ihren Dienst noch immer treu, selbst nach der Verarbeitung vieler Terabyte an Punktwolken. Sie eignet sich für Windows 11, und vor allem die Grafikkarte könnte ein Upgrade vertragen. Heißt das, dass es in den letzten Jahren tatsächlich nur geringe Fortschritte bei der Rechenleistung gab?
Eine fundierte Einschätzung erfordert, die Leistung zu messen und in den historischen Kontext einzuordnen. Gemessen wird mit Benchmarks – beliebt sind Cinebench und Geekbench. Diese laufen jedoch nicht auf alter Hardware, wodurch ein Vergleich über viele Computergenerationen hinweg unmöglich wird.
Im Bereich der Supercomputer und wissenschaftlichen Berechnungen ist das wichtigste Leistungsmaß, wie schnell numerische Berechnungen mit Gleitkommazahlen ausgeführt werden können. Diese Rechengeschwindigkeit wird in FLOPS angegeben, was für floating point operations per second (Gleitkommaoperationen pro Sekunde) steht. Bei Supercomputern wird sie mit dem LINPACK-Benchmark gemessen, der lineare Gleichungssysteme aufstellt und löst – etwas, das Geodäten als Parameterschätzung mit der Methode der kleinsten Quadrate kennen. LINPACK misst die Geschwindigkeit bei der Verarbeitung von 64-Bit-Zahlen, bekannt als double precision (doppelte Genauigkeit). 32-Bit-Zahlen sind single precision (einfache Genauigkeit).
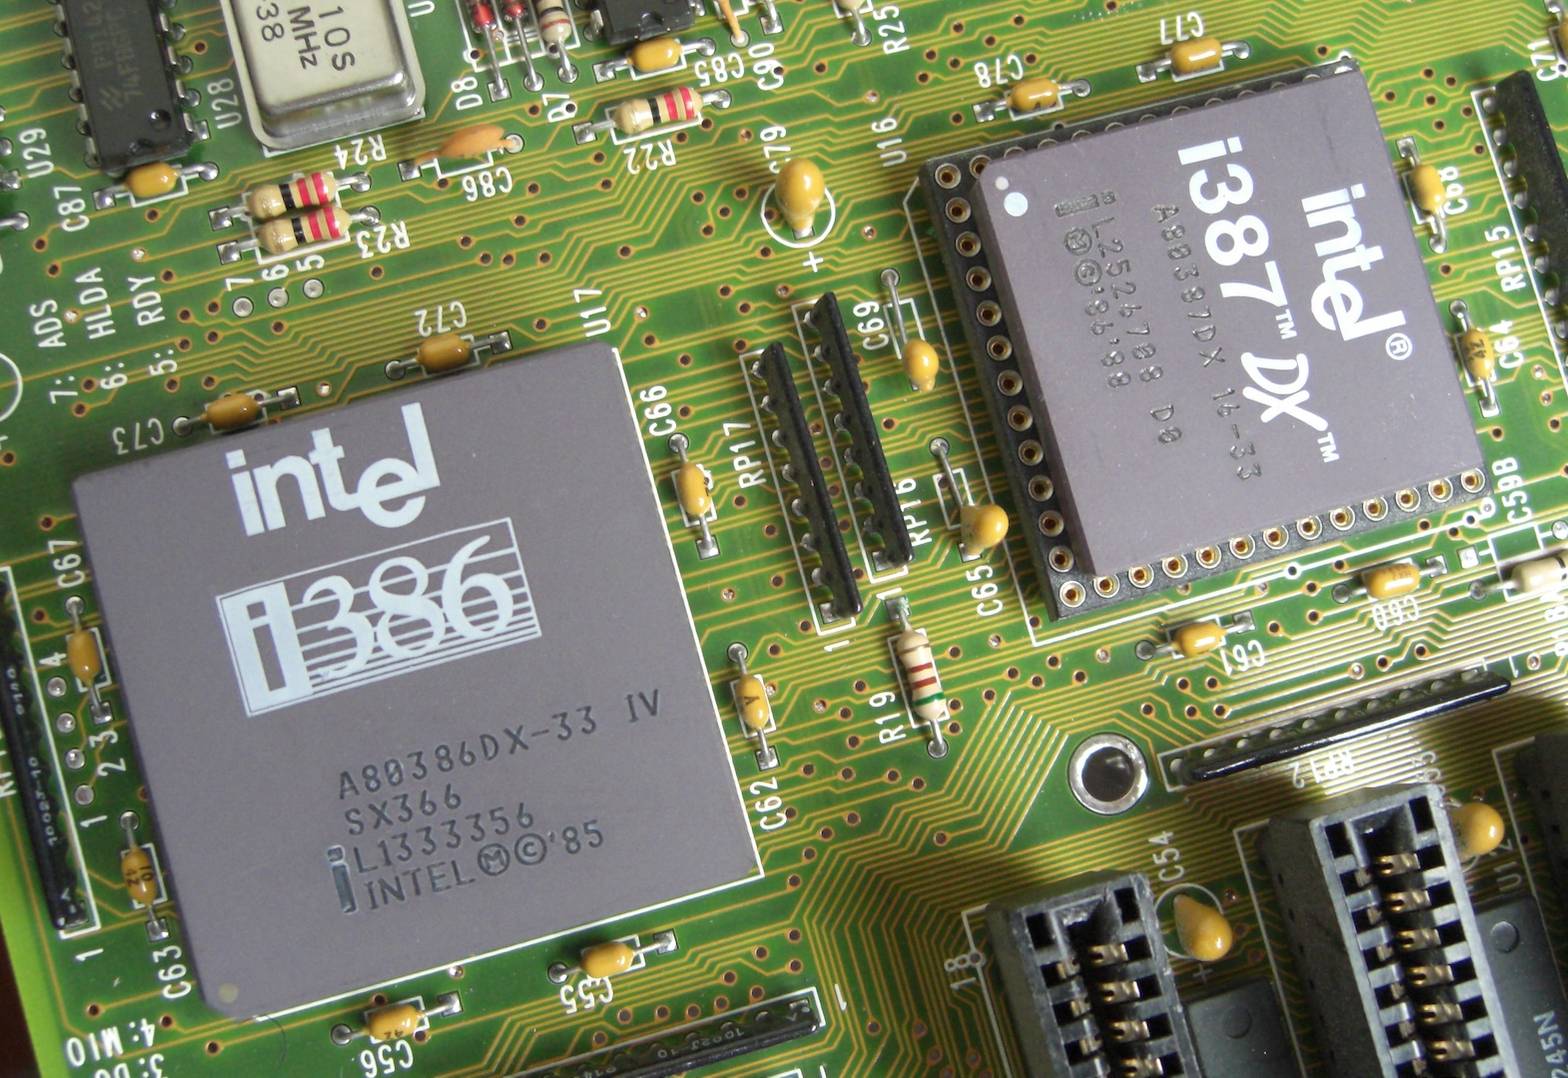
Das Schöne ist, dass viele historische FLOPS-Messungen und LINPACK-Ergebnisse verfügbar sind, mit denen sich Systeme über mehrere Jahrzehnte hinweg vergleichen lassen. Bei PCs kommt man realistisch nicht weiter zurück als bis zur 486-CPU, da sie die erste x86-CPU mit integrierter Gleitkommaeinheit (FPU) war. Die 386er und frühere CPUs emulierten diese per Software, was sehr langsam war – es sei denn, man kaufte einen externen mathematischen Koprozessor, der beim 386 als 387 bezeichnet wurde.
Schauen wir uns also zunächst Supercomputer an, um noch weiter in die Vergangenheit zu reisen. Die ersten Computer, wie die Zuse Z3 und der ENIAC, wurden für wissenschaftliche Berechnungen entwickelt. Die elektromechanische Z3 brauchte fast eine Sekunde, um zwei Zahlen zu addieren. Der ENIAC war mit mehreren tausend Berechnungen pro Sekunde bereits deutlich schneller. Aber eine Unterscheidung zwischen Supercomputern und „normalen“ Computern wurde erst in den 1960er-Jahren getroffen, als die allgemeine Nutzung von Computern richtig an Fahrt aufnahm. Und mit „normalen“ Computern meinen wir natürlich raumfüllende Großrechner wie IBMs System/360, die damals meistverkaufte Computerfamilie.
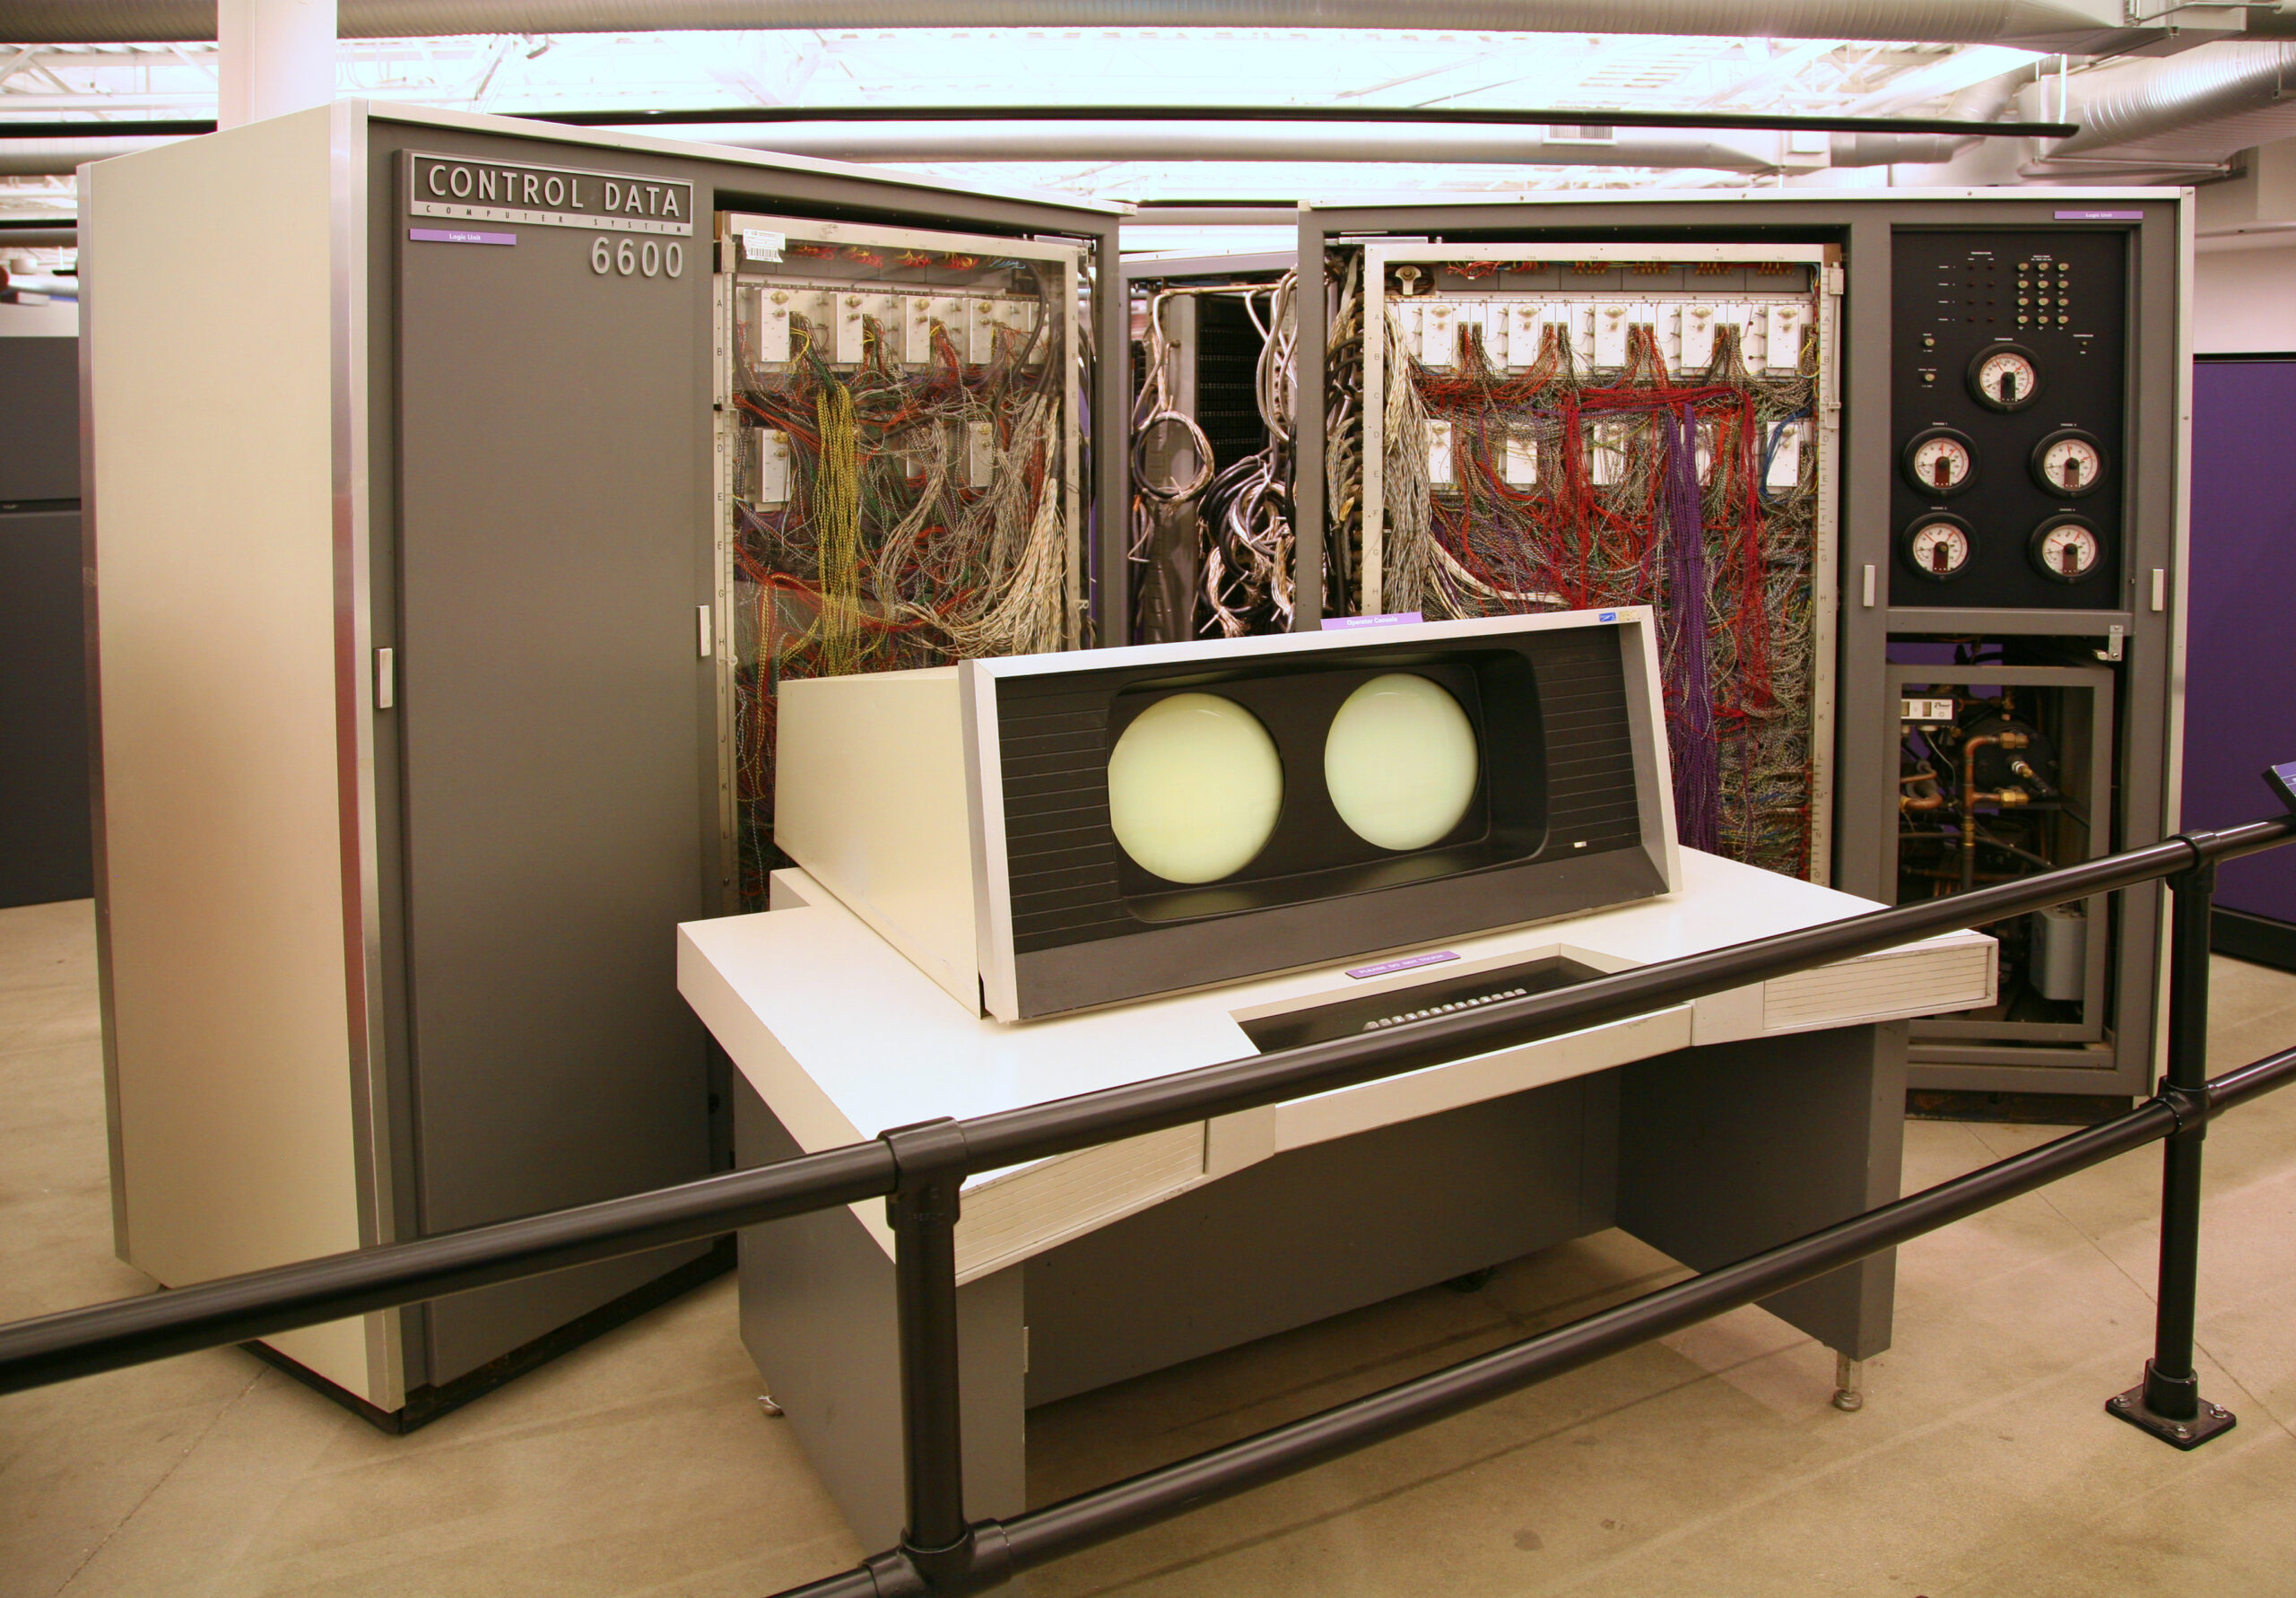
1964 brachte die Control Data Corporation ihre CDC 6600 auf den Markt, die üblicherweise als erster echter Supercomputer gilt. Sie erreichte 3 MFLOPS, d. h. drei Millionen Berechnungen pro Sekunde.
Die CDC 6600 wurde von einem gewissen Seymour Cray entworfen. Manchen Lesern dürfte dieser Name etwas sagen. 1972 gründete er sein eigenes Unternehmen: Cray Research. Seitdem ist Cray fast gleichbedeutend mit Supercomputern.
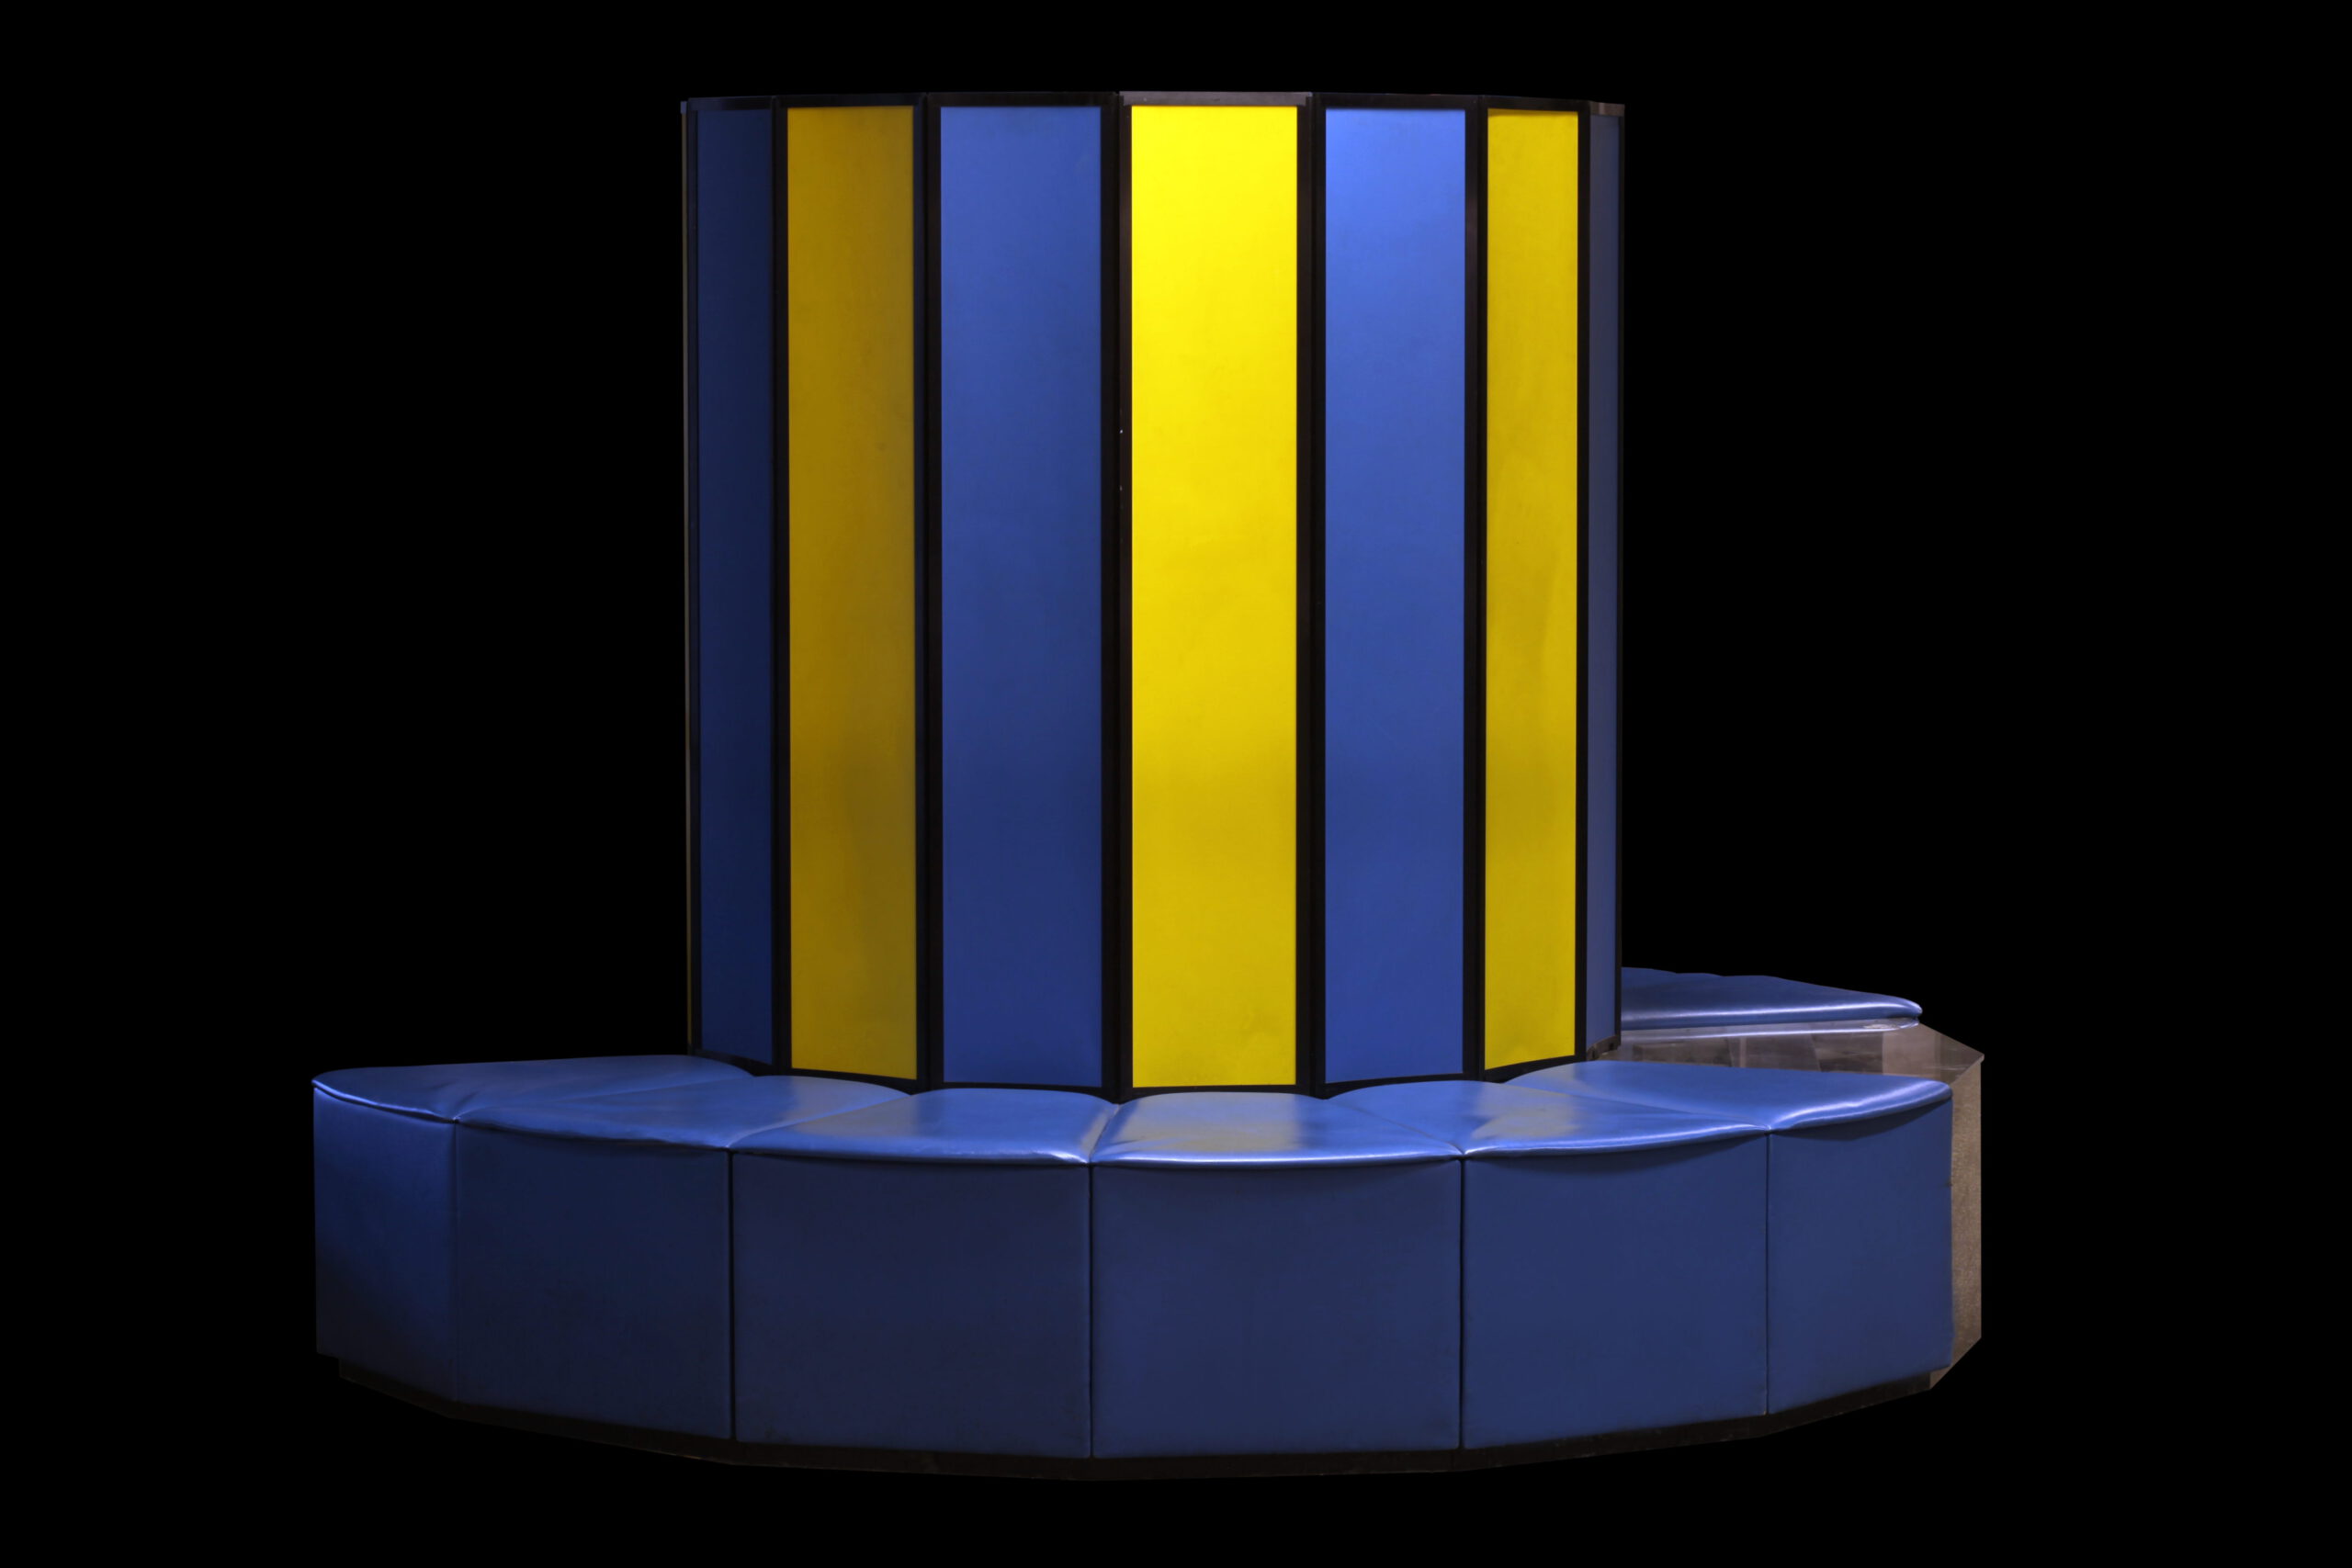
Die Cray X-MP war ein erfolgreiches Modell und von 1983 bis 1985 mit 800 MFLOPS der schnellste Computer der Welt – fast 300-mal so schnell wie die CDC 6600. Und das, obwohl es sich um ein relativ kompaktes System handelte, das eher wie ein Designermöbel aussah. Der Nachfolger Y-MP durchbrach mit mehr als 2 Milliarden Berechnungen pro Sekunde die GFLOPS-Grenze. Typische Merkmale der Crays jener Zeit sind der Einsatz von Vektorprozessoren (die nicht mit einzelnen Zahlen, sondern mit mehreren gleichzeitig arbeiten) und Flüssigkeitskühlung.
Auch NEC in Japan setzte in seiner SX-Reihe Vektorprozessoren ein. In den 90ern kam jedoch ein neuer Trend auf. Statt eigens entwickelter Vektorprozessoren verwendeten Supercomputer zunehmend sehr viele, deutlich günstigere „Standard“-CPUs. Cray zog mit seiner T3E-Reihe nach, die DECs Alpha-CPUs nutzte. Die schnellste Ausführung der T3E erreichte 891 GFLOPS und war damit 1000-mal schneller als die X-MP von 15 Jahren zuvor. Seit 1993 wird zweimal jährlich eine Liste der 500 schnellsten Computer der Welt veröffentlicht – die TOP500-Liste. Im Juni 2000 belegte diese schnellste Version der T3E Platz 7.
Meinen ersten richtigen Kontakt mit Supercomputern hatte ich 2003 bei einem Besuch des Höchstleistungsrechenzentrums Stuttgart (HLRS), den ich für Geodäsiestudenten organisiert hatte. Damals verfügte das HLRS sowohl über eine NEC SX-5 als auch über eine Cray T3E. Letztere war bei Daimler untergebracht, das nach Quadratmetern Stellfläche abrechnete – ein Vorteil bei der kompakten, flüssigkeitsgekühlten T3E. Die luftgekühlten Systeme standen in den eigenen Hallen des HLRS. Warum zwei Systeme? Massiv parallele Systeme erfordern andere Programmiertechniken als Vektorsysteme, weshalb sich manche Anwendungen besser für das eine oder das andere eignen.
Inzwischen hatte eine dritte Architektur an Beliebtheit gewonnen: Cluster, aufgebaut aus normalen Servern oder Workstations, oft jedoch mit einer schnelleren Netzwerkverbindung. Da sie aus handelsüblichen Komponenten bestanden und ihnen die schnelle interne Verbindung „echter“ Supercomputer fehlte, waren sie deutlich günstiger, aber wiederum nicht für jede Anwendung geeignet.
Für meine Masterarbeit wollte ich mit Supercomputern arbeiten. In der Geodäsie bedeutet das Schwerefeldmodellierung. So verbrachte ich 2004 fünf Monate damit, Algorithmen zur Schwerefeld-Parameterschätzung aus Satellitenbeobachtungen zu parallelisieren und auf den HLRS-Systemen zu testen. Das HLRS hatte gerade ein neues System bei NEC bestellt und als Übergangslösung eine SX-6-Installation erhalten, bis das neue System fertig war; wir bekamen Zugang und Rechenzeit darauf. Es gab natürlich eine Warteschlange, sodass man oft Stunden oder sogar Tage warten musste, bis der eigene Job lief. Wir „lösten“ das, indem wir Berechnungen auf dem Front-End-System TX-7 ausführten, das dank 16 Itanium-II-CPUs auch nicht gerade langsam war …
NEC war damals ein großer Name, da das Unternehmen 2002 den Earth Simulator geliefert hatte. Mit einer Geschwindigkeit von 36 TFLOPS war er fünfmal schneller als die Nummer zwei der TOP500-Liste und blieb mehr als zwei Jahre lang an der Spitze. Die TFLOPS-Grenze war bereits 1997 vom massiv parallelen ASCI Red durchbrochen worden, der mit Intel-Pentium-Pro-CPUs lief.
Nach meinem Abschluss an der Universität Stuttgart begann ich als Doktorand an der Technischen Universität Delft. Zunächst hatten wir Zugang zu den niederländischen nationalen Supercomputern TERAS und ASTER. Noch besser: 2005 bewilligte man uns die Mittel, einen eigenen Cluster zu kaufen. Dieses System, das ich CLEOPATRA getauft hatte, bestand aus 33 Knoten (einzelnen Computern), die über Infiniband verbunden waren, mit einer Höchstgeschwindigkeit von über 600 GFLOPS. Fünf Jahre zuvor hätte das für einen Platz unter den obersten 10 % der TOP500-Liste gereicht.
Gegen Ende meiner Promotion war mir CLEOPATRA zu klein geworden, vor allem beim Arbeitsspeicher. Ich wandte eine Filtertechnik an, zu der ein Zuhörer bei einem meiner Vorträge anmerkte: „Mir wurde gesagt, das sei nicht machbar.“ Es war machbar – wenn man genug Rechenleistung hatte. 2009 stellte diese der neue nationale Supercomputer Huygens 2 bereit, ein System mit 60 TFLOPS – 100-mal so schnell wie unsere CLEOPATRA.
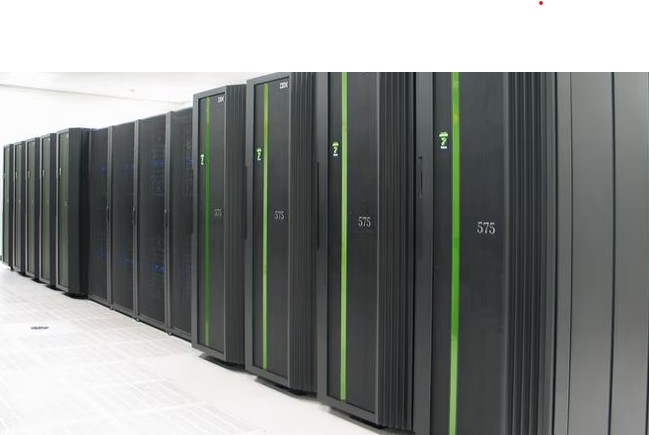
Heute, 15 Jahre später, sind 60 TFLOPS nicht mehr beeindruckend. Das „langsamste“ System der TOP500-Liste vom November 2025 erreicht 2,5 PFLOPS. Wir sind aber bereits in der Exascale-Ära angekommen – der schnellste Computer zum Zeitpunkt des Schreibens ist El Capitan mit 1,7 EFLOPS Spitzenleistung. Er wurde von Cray gebaut, heute eine Tochtergesellschaft von HP. Der Vergleich moderner Supercomputer mit denen des letzten Jahrhunderts ist etwas unfair, da es sich inzwischen immer um vernetzte, modulare Systeme handelt, die oft ganze Hallen füllen, und nicht mehr um relativ kompakte monolithische Systeme. Das bedeutet, dass die Rechenleistung nicht durch das begrenzt wird, was ein einzelnes System liefert, sondern nur durch Geld, Platz und Stromversorgung.

Aber kehren wir zu den Computern für normale Menschen zurück. Mein 486DX-50 erreichte wahrscheinlich etwa 2 MFLOPS, also etwas weniger als die CDC 6600 30 Jahre zuvor. Der Pentium III 450 erreichte mehr als 60 MFLOPS. Die Geschwindigkeitssteigerung resultierte nicht nur aus der höheren CPU-Taktfrequenz, sondern auch aus schnelleren Berechnungen dank Verbesserungen an der GPU. Die 800 MFLOPS der Cray X-MP wurden von der 3-GHz-Version des Pentium 4 erreicht, die 2002 erschien – in nur dreieinhalb Jahren war Intel von 450 MHz auf 3 GHz und von 60 auf 800 MFLOPS gekommen.
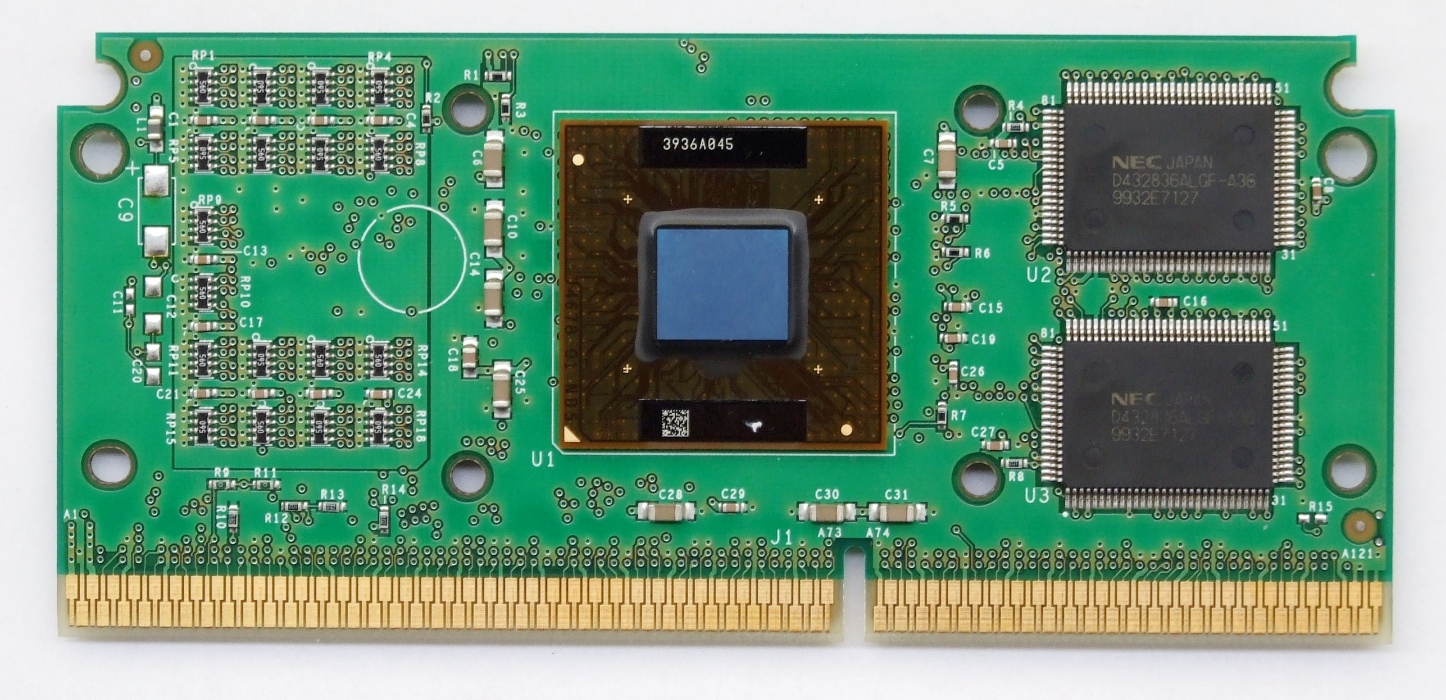
Der Pentium 4 war kein sehr effizientes Design, brachte aber am Ende seines Lebenszyklus zwei wichtige Neuerungen, die heute in allen x86-CPUs verwendet werden: die von AMD entwickelte 64-Bit-Erweiterung des x86-Standards und den ersten Dual-Core-Prozessor mit zwei nahezu unabhängigen Recheneinheiten auf einer CPU. Ich war der erste Mitarbeiter der Fakultät für Luft- und Raumfahrttechnik in Delft mit einem Computer unter dem Schreibtisch, der von diesem Pentium D angetrieben wurde. Er lieferte genug Rechenleistung, bis CLEOPATRA verfügbar wurde.
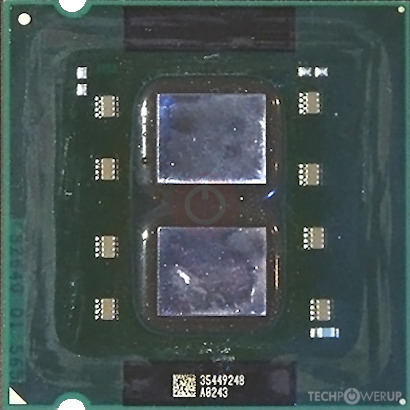
Bisher habe ich immer von LINPACK-Ergebnissen gesprochen, um FLOPS als Maß für die Rechengeschwindigkeit zu erhalten. Ich möchte jedem die Möglichkeit geben, einen Benchmark auszuführen, aber der vollständige LINPACK-Benchmark ist für den durchschnittlichen Computer vielleicht etwas zu viel und zu schwierig zu installieren. Ein wichtiger Bestandteil davon ist die Matrix-Matrix-Multiplikation. Diese lässt sich recht gut optimieren, weshalb viele Computer ihrer theoretischen Spitzenleistung nahekommen (und damit meine ich 50 % oder besser). Der Pentium D konnte theoretisch zwei Gleitkommaoperationen pro Kern und Taktzyklus ausführen, was bei einer Taktfrequenz von 3 GHz eine theoretische Spitzenleistung von 12 GFLOPS ergibt. Ich habe alte Benchmark-Ergebnisse von mir gefunden, die fast 11 GFLOPS auswiesen, also etwa 90 % der theoretischen Spitzenleistung. Ich weiß nicht, warum die LINPACK-Ergebnisse, die ich für den normalen Pentium 4 gefunden habe, so viel niedriger sind, vielleicht weil hier auch das ineffizientere Lösen der linearen Gleichungssysteme mitzählt? Jedenfalls hätten 11 GFLOPS für den 111. Platz der TOP500-Liste von 10 Jahren zuvor gereicht.
In den 20 Jahren seither ist der Fortschritt nicht stehen geblieben. Sicher, die CPU-Taktfrequenzen erwiesen sich als begrenzt, und wir haben heute Turbo-Boost-Taktraten von knapp 6 GHz, etwa doppelt so viel wie beim Pentium 4 vor 20 Jahren. Aber zwei Dinge sind erheblich gewachsen: die Anzahl der Kerne einer CPU (ein AMD Ryzen 9 9950X hat 16 identische Kerne, ein Intel Core Ultra 9 285 sogar 24 von zwei Typen, Performance- und Effizienzkerne) und die Anzahl der pro Taktzyklus ausgeführten Operationen – inzwischen bis zu 32.
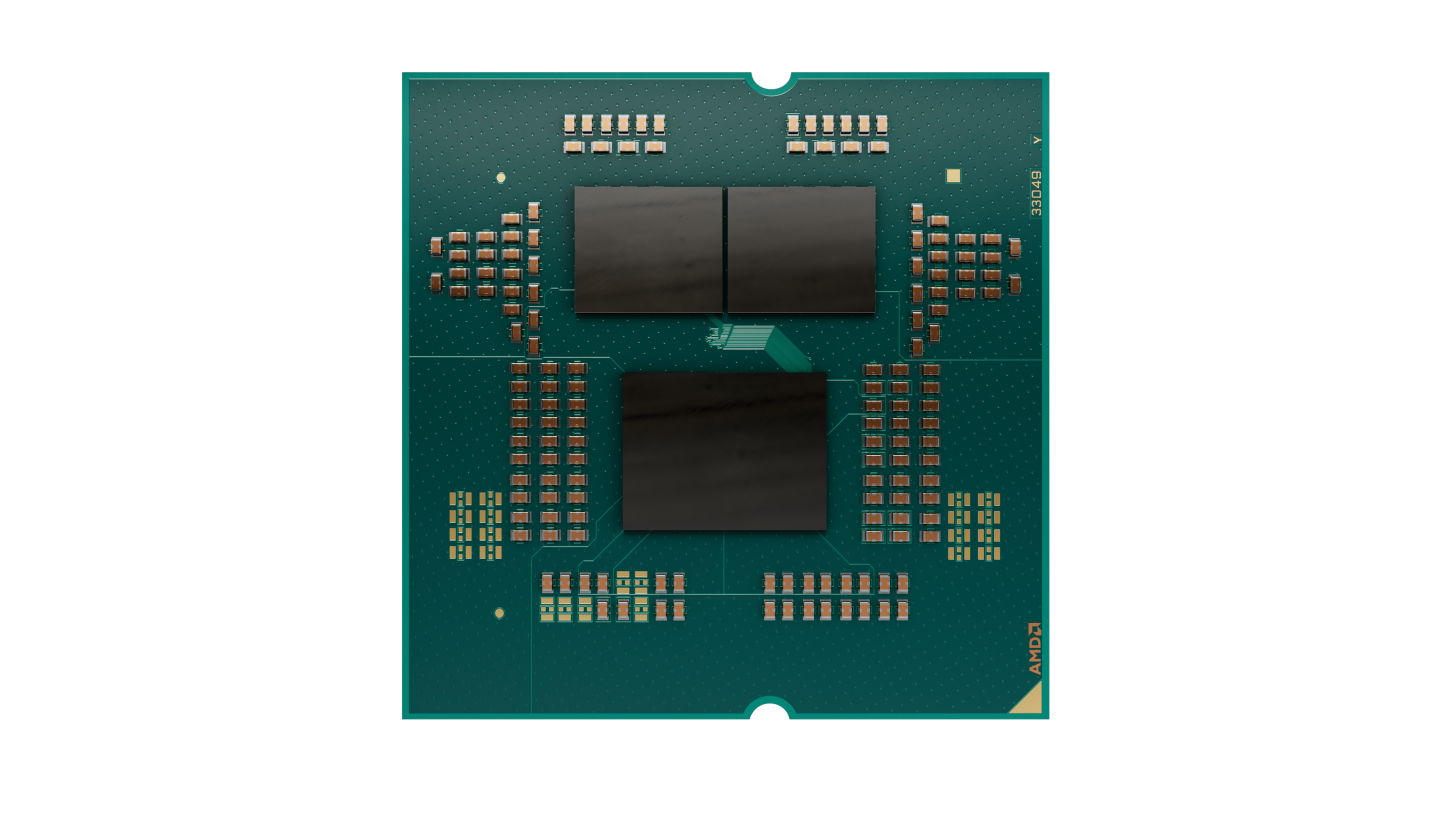
Das bedeutet, dass ein Ryzen 9 9950X eine theoretische Spitzenleistung von über 2 TFLOPS hat. Ich habe zufällig einen unter meinem Schreibtisch und messe mit einem in Python geschriebenen Benchmark-Programm 1,4 TFLOPS – mehr als das 100-Fache des Pentium D von vor 20 Jahren. Meine alte Workstation, ausgestattet mit einem Intel Core i5-9600K, erreicht 250 GFLOPS, etwas mehr als ein Sechstel.
Aber Moment mal, nutzt heutzutage nicht jeder GPUs oder davon abgeleitete Beschleuniger? Schauen wir uns die Leistung von Nvidias Spitzenmodell für Spiele an, der RTX 5090. Ich messe nur 1,5 TFLOPS, also 10 % mehr als die CPU – was für eine Enttäuschung!
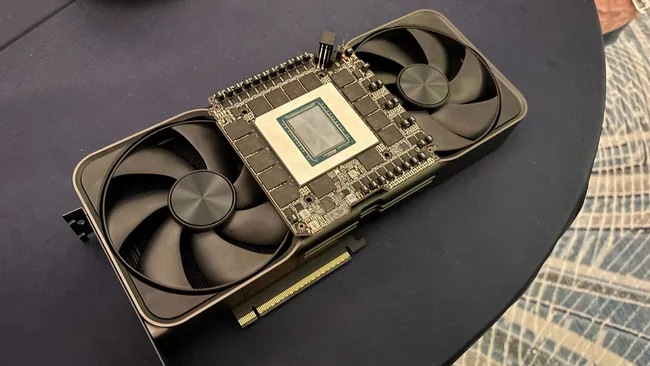
Der Grund? Nvidias Consumer-GPUs und die davon abgeleiteten Workstation-GPUs sind bei 64-Bit-Berechnungen mit doppelter Genauigkeit sehr langsam. Man kann den Benchmark auch mit 32-Bit-Zahlen einfacher Genauigkeit ausführen. Dann erhalte ich 3,2 TFLOPS für den Ryzen 9 9950X und (je nach Matrixgröße) 25 bis 30 TFLOPS für die RTX 5090 – 16-mal schneller als bei doppelter Genauigkeit. Wer die volle Rechenleistung in doppelter Genauigkeit benötigt, muss für eine der High-End-GPUs deutlich mehr Geld ausgeben. Die RTX 2070 in meiner alten Workstation schaffte in einfacher Genauigkeit bereits 5 TFLOPS, der Fortschritt über 5 Jahre ist hier also sogar noch geringer als bei der CPU.
Also nein, die Rechenleistung wächst nicht mehr so schnell wie vor 25 Jahren, als wir Verzehnfachungen innerhalb von drei Jahren hatten. Dadurch haben Supercomputer den Abstand wieder vergrößert. Während ein Pentium D der TOP500-Liste von 10 Jahren zuvor relativ nahegekommen wäre, ist das beim Ryzen 9 9950X nicht mehr der Fall – 2015 brauchte man 200 TFLOPS, um es überhaupt auf die Liste zu schaffen.
Aber ist das schlimm? Ich glaube nicht. Wir sind an einem Punkt angekommen, an dem ein Computer von vor ein paar Jahren für die täglichen Aufgaben, die ohnehin oft im Webbrowser stattfinden, immer noch bestens funktioniert. Der allgemeine Eindruck ist, dass vor allem Gamer immer mehr Leistung verlangen. Dadurch verschiebt sich die Aufmerksamkeit auch hin zur Recheneffizienz statt nur zur Rechenleistung. Ein Laptop, der einen ganzen Tag mit einer einzigen Akkuladung läuft, vor ein paar Jahren noch ein Traum, ist heute Realität. Auch bei Supercomputern rückt die Effizienz zunehmend in den Fokus – inzwischen gibt es auch eine GREEN500-Liste, die Systeme nach GFLOPS pro Watt verbrauchter Energie einstuft.
Quellen
https://en.wikipedia.org/wiki/Floating_point_operations_per_second
http://www.roylongbottom.org.uk/linpack%20results.htm
Wittwer, T.: An Introduction to Parallel Programming. PDF.
Benchmark-Code
Dieser Code wurde von Github Copilot geschrieben und von mir unter Verwendung von CuPy erweitert. Sie benötigen eine geeignete Nvidia-GPU, das CUDA Toolkit und natürlich CuPy.
import argparse
import time
from typing import Tuple, Callable, Dict
import numpy as np
import cupy as cp

#!/usr/bin/env python3
"""
Matrix-matrix multiplication benchmark.

Usage examples:
    python bench_matmul.py --sizes 256 512 --repeats 3 --methods numpy python einsum
    python bench_matmul.py --size 1024 --repeats 5
"""

def parse_args():
        p = argparse.ArgumentParser(description="Matrix-matrix multiplication benchmark")
        p.add_argument("--sizes", "-s", nargs="+", type=int, default=[256, 512, 1024, 8192],
                                     help="Square matrix sizes to benchmark (space separated).")
        p.add_argument("--repeats", "-r", type=int, default=3, help="Number of repetitions per test.")
        p.add_argument("--dtype", "-d", choices=["float64", "float32"], default="float64")
        p.add_argument("--seed", type=int, default=42, help="Random seed")
        p.add_argument("--methods", "-m", nargs="+",
                                     choices=["numpy", "einsum", "python", "cupy"],
                                     default=["numpy", "einsum","cupy"],
                                     help="Which implementations to run.")
        return p.parse_args()

def make_matrices(n: int, dtype=np.float64, seed: int = 0) -> Tuple[np.ndarray, np.ndarray]:
        rng = np.random.default_rng(seed + n)
        A = rng.standard_normal((n, n), dtype=dtype)
        B = rng.standard_normal((n, n), dtype=dtype)
        return A, B

def ops_count(n: int) -> int:
        # For square n x n: 2*n^3 floating-point operations (mul + add)
        return 2 * (n ** 3)

def bench(func: Callable[[np.ndarray, np.ndarray], np.ndarray],
                    A: np.ndarray, B: np.ndarray, repeats: int) -> Tuple[float, np.ndarray]:
        # warm up
        C = func(A, B)
        t0 = time.perf_counter()
        for _ in range(repeats):
                C = func(A, B)
        t1 = time.perf_counter()
        elapsed = (t1 - t0) / repeats
        return elapsed, C


def impl_cupy(A: np.ndarray, B: np.ndarray) -> np.ndarray:
        return cp.asnumpy(cp.matmul(cp.asarray(A),cp.asarray(B)))


def impl_numpy(A: np.ndarray, B: np.ndarray) -> np.ndarray:
        return np.matmul(A,B)
        #return A.dot(B)

def impl_einsum(A: np.ndarray, B: np.ndarray) -> np.ndarray:
        return np.einsum("ik,kj->ij", A, B, optimize=True)

def impl_python(A: np.ndarray, B: np.ndarray) -> np.ndarray:
        # Pure-Python triple loop on lists. Very slow for large n.
        # Convert to nested lists for faster indexing in Python.
        a = A.tolist()
        b = B.tolist()
        n = len(a)
        # initialize zero matrix
        c = [[0.0] * n for _ in range(n)]
        for i in range(n):
                ai = a[i]
                ci = c[i]
                for k in range(n):
                        aik = ai[k]
                        bk = b[k]
                        # unroll inner add across j
                        for j in range(n):
                                ci[j] += aik * bk[j]
        return np.array(c, dtype=A.dtype)

def main():
        args = parse_args()
        dtype = np.float64 if args.dtype == "float64" else np.float32

        impls: Dict[str, Callable[[np.ndarray, np.ndarray], np.ndarray]] = {}
        if "numpy" in args.methods:
                impls["numpy"] = impl_numpy
        if "einsum" in args.methods:
                impls["einsum"] = impl_einsum
        if "python" in args.methods:
                impls["python"] = impl_python
        if "cupy" in args.methods:
                impls["cupy"] = impl_cupy

        print(f"Matrix-matrix multiplication benchmark")
        print(f"Sizes: {args.sizes}, repeats: {args.repeats}, dtype: {args.dtype}, methods: {list(impls.keys())}")
        print(f"{'method':10s} {'n':6s} {'time(s)':>10s} {'GFLOPS':>10s} {'max_err':>12s}")

        for n in args.sizes:
                A, B = make_matrices(n, dtype=dtype, seed=args.seed)
                # reference result (numpy) for correctness
                C_ref = impl_numpy(A, B)
                ops = ops_count(n)
                for name, fn in impls.items():
                        # warn if python impl with large n
                        if name == "python" and n > 512:
                                # still run, but it may be extremely slow
                                pass
                        try:
                                elapsed, C = bench(fn, A, B, repeats=args.repeats)
                        except Exception as e:
                                print(f"{name:10s} {n:6d} ERROR during run: {e}")
                                continue
                        gflops = ops / elapsed / 1e9
                        max_err = float(np.max(np.abs(C - C_ref)))
                        print(f"{name:10s} {n:6d} {elapsed:10.6f} {gflops:10.3f} {max_err:12.3e}")

if __name__ == "__main__":
        main()