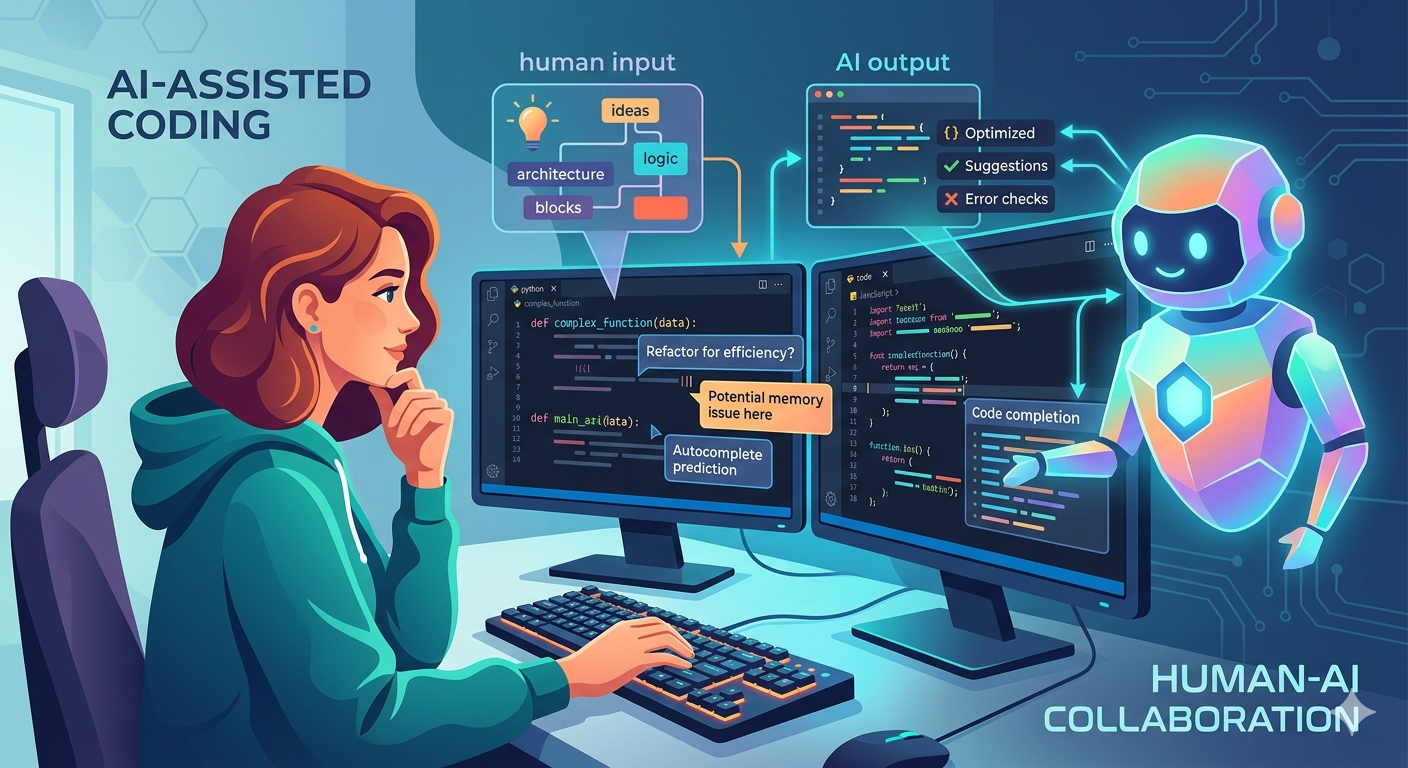
Als je het nieuws over de effecten van AI op softwareontwikkeling volgt, kom je enorm uiteenlopende beweringen tegen. De voorstanders beweren dat AI-assistentie de snelheid met 40% verhoogt en dat in 2030 95% van alle code door AI wordt geschreven. Maar er zijn ook onderzoeken die stellen dat de efficiëntie in werkelijkheid met 25% daalt, omdat er zoveel tijd verloren gaat aan het refactoren van de AI-resultaten. Ik heb gesproken met programmeurs die zelf nauwelijks nog een regel code schrijven, met anderen die AI alleen voor specifieke taken gebruiken (zoals het schrijven van tests), en met enkelen die AI helemaal weigeren te gebruiken – om volkomen legitieme redenen, zoals de milieu-impact, kwesties rond intellectueel eigendom, stijgende kosten, en zorgen over digitale soevereiniteit en afhankelijkheid van Amerikaanse bedrijven.
Daarnaast zijn er de horrorverhalen over open-sourceprojecten die overspoeld worden met door AI gegenereerde pull requests en over bedrijven die per ongeluk tienduizenden dollars uitgeven aan API-aanroepen. Wat is dus de realiteit, daar in de (spreekwoordelijke) loopgraven? Na enkele eerste tests met wisselende resultaten gebruik ik nu al een paar maanden Claude Code – eerst met een Pro-abonnement, nu Max – voor een groot aantal programmeerproblemen en programmeertalen. Ik denk dus dat ik enigszins het recht heb om mijn kijk te geven op waar we nu staan.
Het geheugenprobleem
Ik denk dat veel van de problemen die mensen ervaren bij het programmeren met AI-assistentie voortkomen uit het feit dat men niet begrijpt dat Large Language Models geen langetermijngeheugen hebben waarin eerdere ervaringen worden opgeslagen. Ontwikkelaars staan soms perplex als hun AI-assistent dezelfde fout maakt als vorige week – bij mij heeft Claude eens de verkeerde bestanden bewerkt, omdat het was vergeten dat het een nieuwe versie in een submap had aangemaakt.
LLM’s leren niet tijdens het gebruik. Ze leren alleen tijdens de training. Daarna liggen de gewichten die de kennis van het model bepalen vast. Het enige “geheugen” dat een LLM heeft, is de context. Dat is alle informatie, zoals de chatgeschiedenis, die bij elk verzoek aan het model wordt gevoed. De enige manier waarop een LLM dingen kan “onthouden” en meenemen, is door ze steeds opnieuw aan te leveren. Daarom is de contextgrootte zo belangrijk – alleen met een groot contextvenster kan een LLM veel informatie, zoals een grote codebase, meenemen. Dit is ook de reden dat coding assistants vaak de nieuwste versies van zich ontwikkelende libraries en frameworks niet kennen en geneigd zijn deprecation-waarschuwingen te produceren – hun kennis ligt vast op het moment van de training.
Een gedeeltelijke oplossing zijn bestanden als AGENTS.md, CLAUDE.md en andere markdown-bestanden die instructies en geleerde lessen bevatten – sommige gegenereerd door de menselijke ontwikkelaar, sommige door de coding assistant zelf. Door ze bij elke prompt aan het model te voeren, geef je het verzoek een context mee. Het probleem is dat grote contextvensters veel tokens vereisen, dus alleen de beste en duurste modellen bieden zeer grote contextvensters. Zelfs dan is het begrijpen van een zeer grote codebase en alle afhankelijkheden daarvan lastig. Je zult merken dat, zelfs bij een kleiner project, een nieuwe sessie de volledige codebase moet inlezen (die het misschien pas een paar minuten eerder in een andere sessie zelf heeft geschreven) om te begrijpen wat er aan de hand is.
Claude heeft functionaliteit die skills heet – dat klinkt indrukwekkend, maar het betekent in wezen alleen dat een sessie wordt geïnitialiseerd met specifieke instructies zoals “je bent een security-auditor” enzovoort – dit helpt om het in de goede richting te sturen, maar ontketent niet op magische wijze nieuwe krachten die anders niet beschikbaar zouden zijn.
De gevolgen liggen voor de hand: AI-modellen kunnen uitstekend werk leveren in kleine, op zichzelf staande projecten, maar kunnen moeite hebben met grotere projecten. Hoe specifieker de taak en hoe kleiner de hoeveelheid code waarmee rekening moet worden gehouden, hoe beter de resultaten. Zelfs dan heb ik Claude urenlang een klein probleem zien proberen te diagnosticeren, waarbij het talloze steeds vergezochtere oplossingen voorstelde – totdat ik het wees op de tien regels code waar de fout optrad.
De behoefte aan snelheid
Wanneer het probleem zich goed leent voor programmeren met AI-assistentie, lijken de resultaten soms bijna magisch. Ik ben soms oprecht verbaasd over de kennis die het heeft, zelfs over nichegebieden zoals structurele gezondheidsanalyse (structural health monitoring) en landmeetkundige problemen. Daarnaast kent het meer programmeertalen dan ik ooit zal kunnen leren. Ik heb Claude niet alleen code laten schrijven in Rust, Python en Swift – het is uiteraard ook thuis in shellscripting, Docker en Ansible.
AI blinkt uit in het schrijven van boilerplate-code, de dingen die ontwikkelaars echt saai vinden. Ik vind het vooral prettig hoe snel het GUI’s kan opleveren. Het schrijven van een eigen GUI voor het labelen in een machinelearning-pipeline is nu een kwestie van minuten, niet van uren of dagen.
Als je nog steeds programmeert door vragen te stellen in een chatvenster en resultaten over te zetten met kopiëren & plakken, doe je het verkeerd. Om de kracht van AI-programmeren echt te benutten, moet je een coding agent gebruiken zoals Claude Code of Codex. Die geeft directe toegang tot code en tools – laat het alleen niet te veel doen, anders kun je straks zelf een horrorverhaal vertellen over verwijderde productiedatabases en andere ongelukken. Maar om snel te itereren is het gebruik van agents essentieel.
Een interessant en misschien niet algemeen bekend aspect is dat moderne AI-modellen multimodaal zijn – ze begrijpen niet alleen taal, ze kunnen ook “zien”, oftewel afbeeldingen interpreteren. Een van de vervelendste dingen aan fotogrammetrie zijn de vele verschillende conventies voor oriëntatiehoeken, waarvoor meestal veel vallen en opstaan nodig is om het uit te zoeken. Nu, omdat Claude kan zien, kan het ook informatie plotten en interpreteren, deze conventies zelf testen en binnen een paar minuten de juiste vinden (meestal – Claude heeft me ook wel eens verteld dat alles er prima uitzag terwijl een afbeelding en de eroverheen gelegde puntenwolk duidelijk gespiegeld waren).
De problemen
Het gebruik van AI wordt momenteel zwaar gesubsidieerd. Zelfs de betaalde abonnementen dekken de kosten niet, dus AI-bedrijven verliezen geld en leven van durfkapitaal. Ik denk niet dat dit eeuwig zal doorgaan – ik verwacht dat de drie belangrijkste aanbieders van AI-modellen voor programmeren (OpenAI, Google, Anthropic) op een gegeven moment gedwongen zullen worden de prijzen te verhogen. Zelfs nu kan API-gebruik op basis van tokens al tot aanzienlijke rekeningen leiden, dus ik raad aan om voor ontwikkeldoeleinden een abonnement te gebruiken.
De andere dreiging is de afhankelijkheid van Amerikaanse AI-aanbieders, een gebrek aan digitale soevereiniteit. Anthropic werd gedwongen de toegang tot Claude Fable al na een paar dagen op te schorten. Wat gebeurt er als de toegang op een gegeven moment helemaal wordt afgesloten, mogelijk als onderdeel van een handelsoorlog? Je modellen lokaal draaien zou als oplossing kunnen worden gezien – maar het probleem is dat de beschikbare open-source- of open-weight-modellen nog niet zo capabel zijn als de commerciële modellen, en dat de hardware die nodig is om grote en krachtige modellen te draaien de afgelopen maanden alleen maar duurder is geworden.
De langetermijneffecten zijn nog niet duidelijk. Verwacht wordt dat de geheugenprijzen de komende tijd hoog blijven. De milieu-impact is onmiskenbaar nu er datacenters op gigawattschaal in aanbouw zijn. Het valt nog te bezien wat de impact op het werk van softwareontwikkelaars zal zijn. AI kan duidelijk het werk van junior ontwikkelaars doen, maar de junior ontwikkelaars van vandaag zijn nodig, want zij zijn de senior ontwikkelaars van de toekomst. En ik ben het over het algemeen oneens met het gebruik van AI om “de efficiëntie te verbeteren”, oftewel om medewerkers te ontslaan. Ons doel zou moeten zijn om zoveel mogelijk mensen in dienst te hebben, niet zo weinig mogelijk – ook vanuit economisch oogpunt.
Mijn belangrijkste conclusie is dus: AI heeft duidelijk een enorme impact op softwareontwikkeling en zal die blijven hebben – maar ik vermijd het om er te afhankelijk van te worden. Gebruik het waar het zinvol is en voordelen biedt, maar blijf flexibel en capabel zonder.